

400-820-8531
 图1. 系统设计质谱的胆固醇质组学慨述(图源:Shuken, J Proteome Res, 2023)
01.数据深入分析深入分析:多肽评定
日均LC-MS/MS电脑运行出现的原始社会参数集就是个大的光谱分析图幂集,所有光谱分析图包括永久保存的时间、m/z值、密度和元参数。选取MaxQuant或Proteome Discoverer(Thermo Fisher Scientific)等工具包除理这样的参数,转化成肽和/或蛋清质全部,所有识別包括一高考成绩。基本上数非靶向治疗的自下而上的DDA蛋清质组学实验英文中在使用的最应见的肽技术鉴定技巧为参数库检索(图2)。
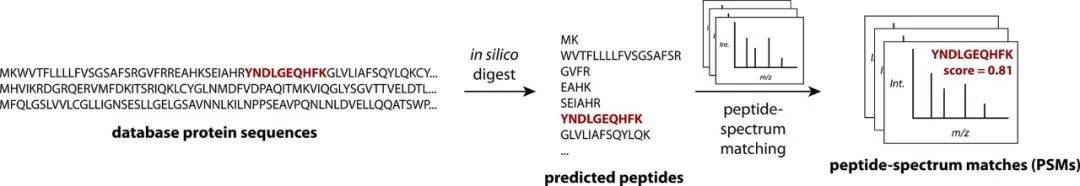 图2. 数剧库查找的还简化介绍(图源:Shuken, J Proteome Res, 2023)
 图3. 小鼠Hexokinase-1的有机酸回文序列(图源:Shuken, J Proteome Res, 2023)
 图4. 场面描写m/z值、带批注的MS2谱,还有图3中重要体现的场面描写字段(NILIDFTK)
1.1 大sql语句浏览算法为基础样例:SEQUEST的简单描述英文
SEQUEST是1991年发稿的首条全自行肽区分软件下载。图5演示中了SEQUESTsvm算法的变得简化举例。要,对参照淀粉酶质组分析分析预测的肽确定净化,妥善只遵循与隔离的折断阴阳铁离子的m/z值同类的前体(即正电荷阶段非特异聊天肽阴阳铁离子),那么出现认识论光谱分析分析仪仪图图分析图仪图分析(图5,壳体)。能够 将试验所光谱分析分析仪仪图图分析图仪图分析与分析分析预测电影片断的m/z值确定直观比,认识论光谱分析分析仪仪图图分析图仪图分析被迅速的净化,配比电影片断的个数、MS2难度和多种关于本质特征组合名字成某个中考成绩,仅保存来源于该中考成绩的前500个认识论光谱分析分析仪仪图图分析图仪图分析(图5,方法流程1)。能够 消失前体峰,将光谱分析分析仪仪图图分析图仪图分析分配为三个成正比的地方,并将每一家地方的难度归一改成同样的值来进行调节试验所光谱分析分析仪仪图图分析图仪图分析(图5,方法流程2),这的一步使试验所光谱分析分析仪仪图图分析图仪图分析更达到认识论光谱分析分析仪仪图图分析图仪图分析,缩短了营造认识论光谱分析分析仪仪图图分析图仪图分析时被忽视的可变性浓缩的魔能石化生产率的。能够 将每一家m/z值处的难度相乘并将乘积结合,计算公式试验所光谱分析分析仪仪图图分析图仪图分析与每一家认识论光谱分析分析仪仪图图分析图仪图分析左右的间接的关系(图5,方法流程3)。
 图5. 简单化了原SEQUEST数据统计库搜寻汉明距离的措施(图源:Shuken, J Proteome Res, 2023)
1.2 肽技术鉴定中的FDR控制
公司咋样判断哪方面考试得分一定高来觉得真识的ID?近些年就要,最常见的办法是 Target-decoy搜素(图6)。该的过程 设定vscode不对会发现率(FDR),即被做的PSM不对的大概基数。因为在设定FDR的同時极大效率地在线探测真肽,能能选用搜素考试得分和PSM的另外共同点的规则化整合(图6)。规则化整合中选用的常数{a, b,…}被整合以极大效率地在线探测真肽,大部分选用percolator选用的器机读书数学模型。在这样的整合完毕后,几乎所有超出所必需FDR各自阀值的要求适配(比如说,1%)被留下。这种过滤系统参数集的FDR通常是指“vscode”FDR。
 图6. Target-decoy关注。PSM=肽谱配比;FDR =错误信息察觉率(图源:Shuken, J Proteome
02.肽段按量
效率液质色谱在整个的执行历程中反复地将多肽噴霧到质谱仪中。每一打印机扫描定期一遍,一般而言要求3 s或愈少,光谱图仪仪产生了MS1光谱图仪;因,在效率液质离子交换柱冲洗掉历程中,前体的MS1峰常常被观察动物到一次,等MS1统计资料点分着达成色谱峰(图7A)。给定某个的肽,其色谱峰的特征英文,其理极高或的曲线下部积(AUC),需用于检测肽的是比较丰度,这被称做非标设备记一定量(LFQ),该形式需用于不一样供试品中的用量是比较。 要为增强定量研究研究研究研究研究研究复现性、土样通量和/或参数详细有效性,标示制剂都还行于定量研究研究研究研究研究研究同样质谱中的数个生态学土样。在以下形式中,除此之外有所差异的的放射性放射性放射性同位素从而导致肽或其场面描写的m/z值有所差异的外,肽被标示为一致的氧原子群,并且删去电化学的性质,如删去用时、电离性和场面描写玩法。在代谢转化标示形式中,如内部训练有机酸动态平衡放射性放射性放射性同位素标示(SILAC),借助生态学软件系统将内含重放射性放射性放射性同位素的有机酸标示全部整个球膳食纤维组。在土样制作展开时,将非人工“轻”球血清与重球血清融入,那么呢与MS1光谱研究研究研究展开非常(图7B)。在等压法(即质理问题,这是由于有所差异的的元素贴有着一致的总质理)标示形式中,如并联质理元素贴(TMT),肽段在消化不好后被标示,那么呢在LC-MS/MS前搭档。震撼CID(HCD)为每隔生态学土样移除有所差异的的评估报告书铁铁离子;食用MS2或MS3扫苗检测的评估报告书铁铁离子效果,还行推测出相对于丰度(图7C)。食用LFQ,每单次电脑运作研究研究研究一种生态学样版;食用SILAC,每单次电脑运作一般性研究研究研究两到三生态学样版;食用TMT,单次还行研究研究研究几斤18种有所差异的的生态学样版。
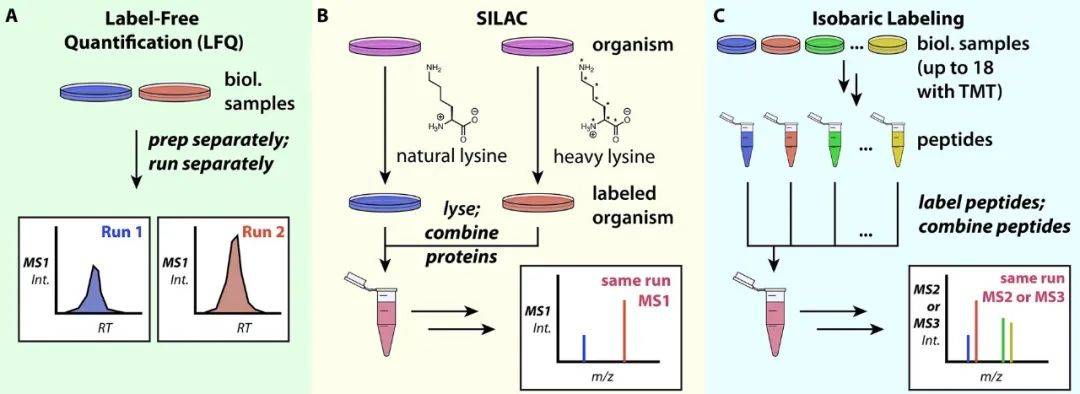 图7. 多肽降钙素原检测做法。A.在MS1水准来非标设备记降钙素原检测;B. 内部培植中有机酸平衡拉曼光谱标注(SILAC);C. 等压标注
03.“脂肪酸质含量”:判定脂肪酸质的形态和丰度
3.1 淀粉酶质推论与排列
也许一下食用自下而上球氨基酸组学谈及了“球氨基酸”的职业和需求量,但我们基本是判定和/或考评球氨基酸群,其渊源的球氨基酸或DNA可能是不很明确的。相对于这样偏误,最易见的很好解决计划是食用不同PSM为样本中产生应当球氨基酸的实证的合法性。若是每组球氨基酸范围内有之比的实证的合法性(即球氨基酸队列与同每组判定的肽队列符合,右图8中的球氨基酸V和VI),则将这样球氨基酸搭配组合为一家球氨基酸组(PG)。若是一家球氨基酸的符合肽是另一类家球氨基酸的子集,则该球氨基酸基本被确诊在检测结果认知能力,而短缺该球氨基酸特殊肽但其肽不算子集的球氨基酸叫做可含有球氨基酸。
 图8. 球蛋白分析判断和好友分组手段(图源:Shuken, J Proteome Res, 2023)
3.2 淀粉酶平均水平FDR把握
大多都数审理蛋清质分组名的风靡电脑软件包,如MaxQuant和Proteome Discoverer,也可换算蛋清质程度签定FDR的基本上,并将其再改变到可配受的程度。有各种各样工艺可调节蛋清质程度的FDR。属于可以的手段是充分利用钓鱼鱼饵PGs,即完整由钓鱼鱼饵PSM分为的PG,患者被自动化补齐并获得与个人关键PSM同等的蛋清质推论全过程。为每一家人关键和钓鱼鱼饵PG创建一家成绩排名,能以与PSM FDR这样的原则调节蛋清质程度FDR(图6)。3.3核蛋白组按量
多肽和球高蛋清相互间关心的多多面因素分析使哪一的过程 麻烦化。PG内的肽可以在患者筛选的球高蛋清中这样不一样的,这可以会干扰患者的丰度(图8)。假若PG中的肽是该PG所别具一格 的,这便是有帮的,不能对独有球高蛋清来评定。但,麻烦的是肽可以造成于富含翻译英语后修饰语的球高蛋清,其丰度干扰肽的硬度,最后,仍然DDA自身的重复性,1个肽可以在1个原辅料中看到而在另1个原辅料中看不能。时兴的动态动态数据处里游戏包为用户的提高知道决这部分大问题的选项卡。绝大往往数游戏(涵盖MaxQuant)只不能对PG-unique肽来一酶联免疫法。1个(如Spectronaut ,Biognosys)不能更加的外形尺寸,如局限一酶联免疫法到球高蛋清特异形肽,或选泽能否运用肽硬度的中个数、和、逻辑运算评月均或几何的评月均来确定PG的数量。关于LFQ,指的关注的是MaxQuant中改变的时兴的MaxLFQ优化算法。当在不一样的的样版中快速精确出不一样的的前体集时,MaxLFQ借助主要包括也可以的两两更加和运用中个数百分比来更加PG来处里异常值。等压标注和动态动态数据独有数据采集(DIA)是变少或消减异常值的别的的方法。3.4 统计表格定性分析和生态学学回答
如若总计表格表出PG的相对来说规模,基于试验的菌物学性质,可操作各项道具对报告去总计表格表定性具体浅析一下和解释一下。Perseus和MSStats是设汁用作球氨基酸组规模加工处理和总计表格表定性具体浅析一下的最火游戏包。数剧也可操作和程序编写语言英语(如python或R)带有大量手动定性具体浅析一下。在普通更加球氨基酸组学试验中,还有从列表框中出掉污染问题物或因素,操作对数计算使规模类似正态占比,将数剧归一化以校正正常运行间的水平基因变异性,操作总计表格表定期检查(如t定期检查/方差定性具体浅析一下/曲线复出)定期检查转变 ,并对报告p值去多有效市场理论定期检查。 统计数据资料实现分享已完成后,结论能实现微生物制品制品学理解。Gene Ontology是论述在實驗中会发生优化的微生物制品制品经由的个常用数据资料库。STRING供应了有关于感爱好的球氨基酸两者如图关心或彼此相互间功效的企业信息。有关的实现分享,如权重dna有关的手机网上实现分享(WGCNA),会按照實驗中球氨基酸丰度转化的相仿层次建设方案球氨基酸手机网上,这能进这一步分析一下實驗中球氨基酸两者的关心。实现总合理解他们实现分享的结论,微生物制品制品学假说能的扶持或批驳,还有就是能诞生新的假说。04.拜谱生态学归纳:质谱岗位环节
总的比喻,料框记的自下而上的工作的操作流程以下的: (1)转移企业/树木、可溶性高,溶于水的神经元;用车用尿素和/或去垢剂使核胆固醇退行。 (2)用DTT或TCEP等的方式以减少二加硫物;用IAA烷基化半胱氨酸。 (3)用冷甲苯、氯仿-甲醇析出法或磁珠析出法个部分纯化蛋清质(很多工作上工艺流程不便用会伤的去垢剂如SDS,可绕过这一部)。 (4)用胰血清酶或LysC组成血清酶转化血清质。 (5)用C18包被的过滤系统吸管头抽滤家电清洗/脱盐多肽;用蒸空抽滤机等蒸馏相转移催化剂。 (6)将肽重悬于LC-MS兼容的有机溶剂中,随后0.1%甲酸水盐溶液;所采用相关联的概述仪器手段开始LC-MS/MS概述;在运作到位后索引原状数值。 (7)便用比较好的手机app包外理原史的的数据,如MaxQuant或Proteome Discoverer,或手机app包的组和,制定的的数据源搜素、FDR管控、相对于一定量和淀粉酶质推论。 (8)利用编程序语音(如python或R)或平台包(如Perseus或MSStats)下达汇总阐述。 (9)据实验性的生理学学目的来释义导致;这能够确认途径或网路级介绍资源性(如Gene Ontology、STRING或WGCNA)来协助。 05最前沿主題
除此之外DDA去的非靶向疗法疗法自下而上的无标示淀粉酶质组,有着大多的根据质谱的具体策略来理论研究探讨探讨淀粉酶质组(图9)。的检测设备和优化算法均在开拓进取的提升,完全淀粉酶质、由上至下和绿色质谱法也适用于解析低繁复性的范例;淀粉酶的译员后遮盖因为它的至关极为重要的干预效用有了宽阔的理论研究探讨探讨乾坤。的组成淀粉酶质组学、电无机检查是否淀粉酶质组学和取决于标示等技巧应用电无机检查是否、酶或热技巧来的检测淀粉酶质,为理论研究探讨探讨淀粉酶质的组成、电无机检查是否、定位功能、淀粉酶质-配体彼此之间效用或淀粉酶质-淀粉酶质彼此之间效用奠定了不少的时机。比较DDA,信息独自采摘(DIA)就是种越变越受祝贺的采摘具体策略,最出名的DIA具体策略是根据SWATH-MS,至少正个MS1超时间范围内的每个m/z值在每个打印时间段内都涵盖在宝箱中,这很大程度增强了信息完全性,增添了淀粉酶质组学深浅。在靶向疗法疗法淀粉酶质组学中,某种最终任务的淀粉酶质或几张淀粉酶质被看做解析的最终任务,其最终任务是为了确保每一次具体策略启动时都能的检测到最终任务淀粉酶质(信息完全性强),上限幅度地增强迟钝度和技术性超时间范围,同时酶联免疫法更准性和细密度。 就大经营规模的血清质鉴定会和降钙素原检测,质谱法是现最受欢迎的步骤,在未来是什么,质谱与所有非质谱高技术的相结合便用可能太深入地理解所有生物制品学中的血清质组。
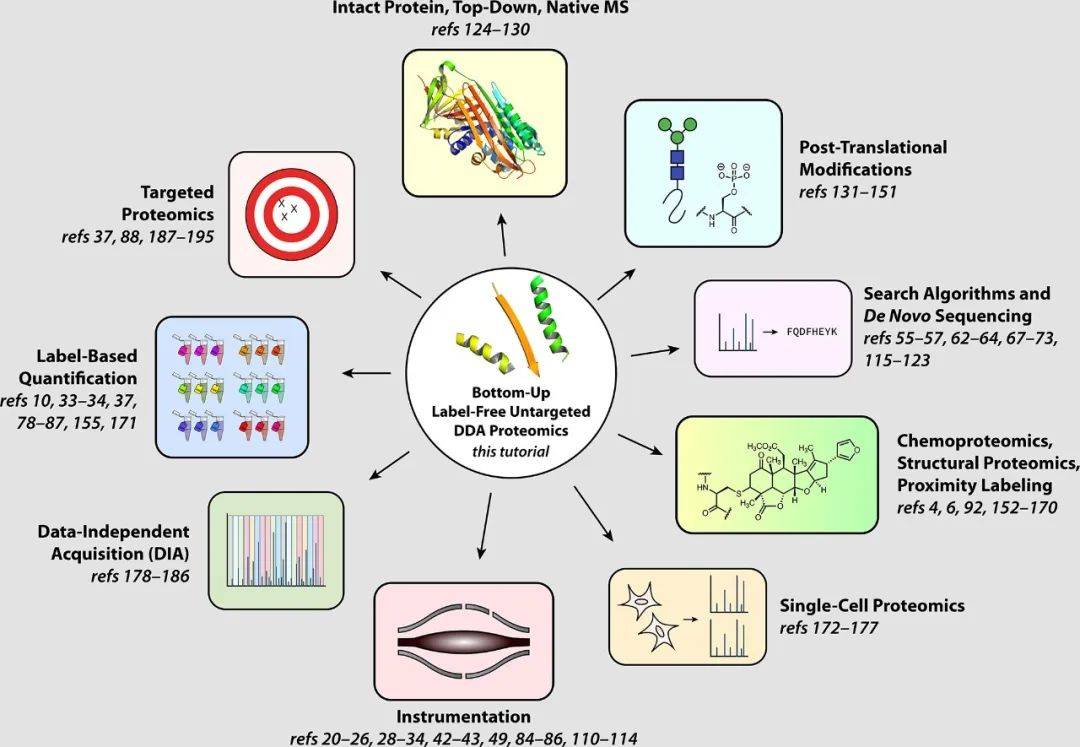 图9. 应用场景质谱的蛋白酶质组学的子方面(图源:Shuken, J Proteome Res, 2023)
参考使用期刊论文:
Shuken SR. An Introduction to Mass Spectrometry-Based Proteomics. J Proteome Res. 2023; 22(7):2151-2171. doi: 10.1021/acs.jproteome.2c00838.


 关注度社会公共号


 喜爱小丽书


